Künstliche Intelligenz
Wissen auf Abruf: Was wirklich hinter den KI-Antworten steckt
Zarah Ziadi
15. Oktober 2026
Wissen ist mehr als eine Antwort
Eine Frage eingeben, wenige Sekunden warten, eine fertige Antwort erhalten: Generative KI macht es so einfach wie nie, Informationen abzufragen. Doch leicht gerät aus dem Blick, was dahintersteckt: verlässliche Quellen, offene Wissenssammlungen und vor allem Menschen, die Wissen zusammentragen, überprüfen und zugänglich machen.
KI erzeugt Wissen nicht selbst. Die Systeme greifen auf Inhalte aus dem offenen Web zurück, darunter auch auf Wikipedia. Dort recherchieren, schreiben und diskutieren ehrenamtliche Wikipedia-Autor*innen, prüfen Quellen und korrigieren Fehler. Was sie gemeinsam schaffen, wird zunehmend von Maschinen verarbeitet und als neue Antwort ausgegeben.
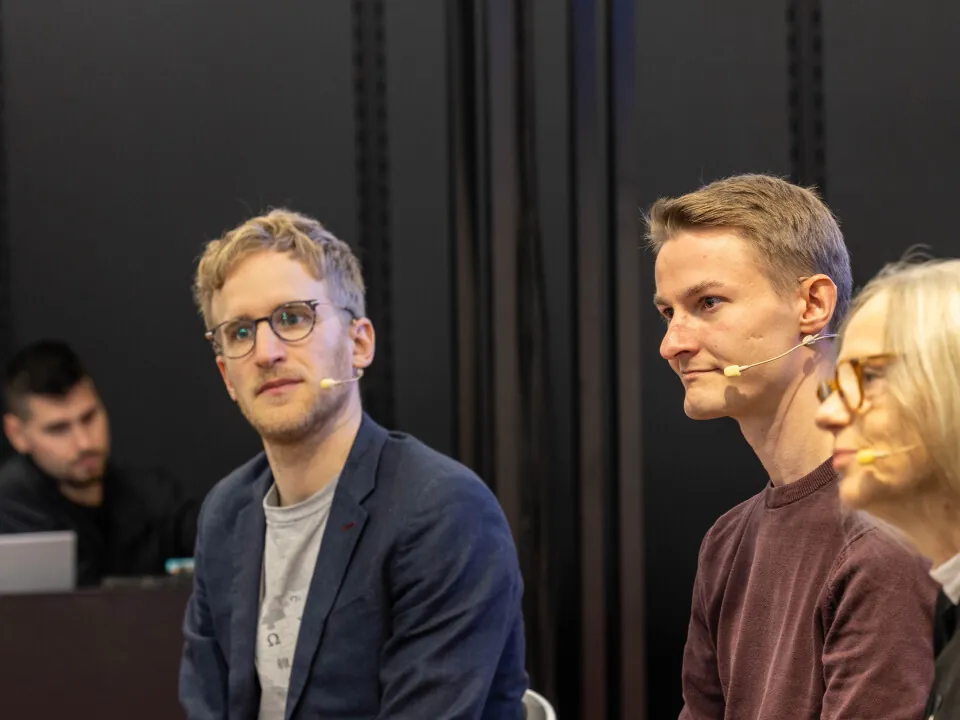
Aber was passiert dabei mit dem Wissen, seiner Herkunft und den Menschen dahinter? Wie können wir nachvollziehen, auf welchen Quellen eine Antwort beruht? Welche Regeln gelten für die Nutzung der neu erstellten Inhalte? Diese Fragen haben der Wikipedia-Administrator Johannes Richter und Rechtsanwalt und Wikipedianer Lukas Mezger auf der Frankfurter Buchmesse beleuchtet.
Die technologische Perspektive: Eine Antwort ist noch kein Nachweis
Was bei KI-generierten Antworten oft fehlt, ist der Blick hinter die Kulissen: Welche Quellen wurden verwendet? Welche Aussagen daraus übernommen? Und was wurde zusammengeführt, verändert oder weggelassen?
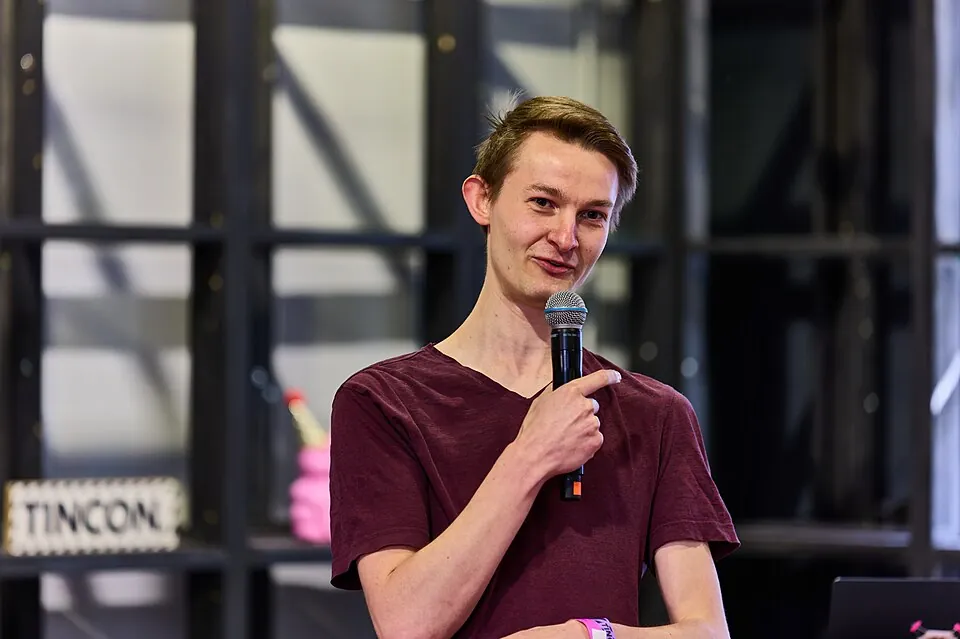
Johannes Richter ist Administrator in der deutschsprachigen Wikipedia. In dieser Rollebefasst er sich mit den Auswirkungen von Künstlicher Intelligenz auf die Wikimedia-Projekte. Gemeinsam mit anderen Wikipedianer*innen arbeitet er an Richtlinien und Instrumenten, um zu gewährleisten, dass Wikipedia ein Projekt von Menschen für Menschen bleibt.
Wie Johannes Richter erklärt, funktionieren Sprachmodelle anders als Wikipedia. Sie werden mit großen Mengen digitaler Texte trainiert und lernen daraus statistische Muster, auf deren Grundlage sie Antworten formulieren. Manche Systeme greifen zusätzlich auf aktuelle Quellen zurück. Aus vielen Informationen entsteht so eine neue Antwort. Sie kann Inhalte aus unterschiedlichen Quellen verbinden, neu formulieren und verdichten. Die konkrete Formulierung der KI muss deshalb nicht in einer einzelnen Quelle wiederzufinden sein. Das macht die Herkunft des Wissens schwerer nachvollziehbar.
Wikipedia hingegen macht transparent, wer an Artikeln mitarbeitet, welche Quellen verwendet werden und wie sich Inhalte verändern. Belege, Diskussionen und Versionsgeschichten machen den Entstehungsprozess sichtbar.
Nicht ausreichend: Links zu Webseiten
Ein paar Links unter einer KI-Antwort reichen deshalb nicht unbedingt aus. Ein Link zeigt zunächst, wo weitere Informationen zu finden sind. Er beweist noch nicht, dass die verlinkte Quelle die konkrete Aussage tatsächlich stützt. Bei zusammengesetzten Antworten wird es besonders knifflig: Welche Passage hat zu welcher Aussage beigetragen? Welcher Kontext wurde übernommen? Welche Version einer Quelle war relevant?
Echte Nachvollziehbarkeit braucht daher mehr als eine Quellenliste. Technisch müsste sich laut Richter der Weg von einer konkreten Aussage zu den zugrunde liegenden Informationen nachvollziehen lassen – einschließlich relevanter Textstellen, Kontext und Quellenversionen. Auch müsste klarer werden, ob eine Information aus dem Training eines Modells stammt oder bei der Anfrage aktuell abgerufen wurde.
Das ist keine bloße Detailfrage für Entwickler*innen. Es geht um etwas viel Fundamentaleres: die Grundlage öffentlicher Debatten. Wenn zwei Menschen dieselbe Frage stellen und unterschiedliche, individuell zusammengestellte Antworten durch generative KI erhalten, fehlt womöglich ein gemeinsamer Bezugspunkt. Eine offene Wissensbasis wie Wikipedia kann dagegen einen Raum schaffen, in dem Menschen auf dieselben Informationen und Belege zurückgreifen und darüber diskutieren können.
Die juristische Perspektive: Wissen ist frei – aber nicht alles daran
Dass Wissen in generative KI-Antworten einfließt, wirft nicht nur technische Fragen auf. Es geht auch um die rechtliche Dimension: Darf ein KI-Unternehmen fremde Texte, Bilder oder andere Inhalte für das Training seiner Modelle nutzen? Und was gilt, wenn diese Inhalte unter freien Lizenzen veröffentlicht wurden?
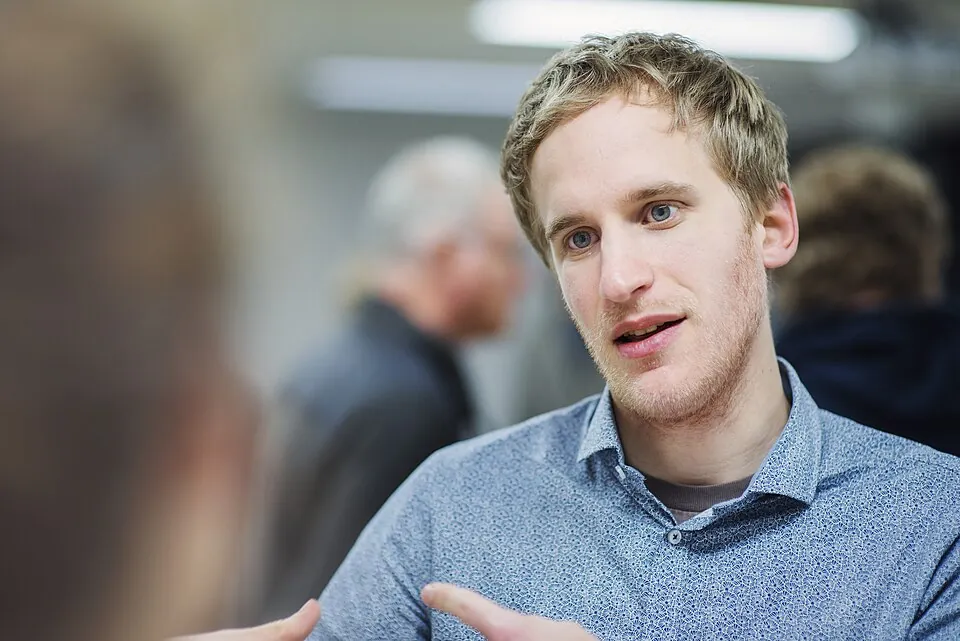
Lukas Mezger ist Rechtsanwalt für IT- und Medienrecht in Hamburg mit Schwerpunkten im Datenschutz- und KI-Recht und seit vielen Jahren aktives Mitglied der ehrenamtlichen Wikipedia-Autor*innen-Community. Er veröffentlicht regelmäßig Fachbeiträge zu aktuellen juristischen Themen der Medienbranche. Bis 2022 war er außerdem Vorsitzender des Präsidiums von Wikimedia Deutschland.
Für Rechtsanwalt und Wikipedianer Lukas Mezger ist das ein Spannungsfeld. Ein wichtiger Ausgangspunkt: Wissen und Fakten als solche sind nicht urheberrechtlich schutzfähig. Geschützt sein kann aber die konkrete Form, in der Wissen ausgedrückt wird, sowie Sammlungen und Datenbanken. Wer Inhalte nutzt, muss deshalb unterscheiden: Geht es um eine Information an sich – oder um ein geschütztes Werk, in dem diese Information dargestellt ist?
Für das KI-Training ist diese Unterscheidung entscheidend. Die Nutzung urheberrechtlich geschützter Werke kann eine Lizenz erfordern. Zwar gibt es gesetzliche Ausnahmen, etwa für bestimmte Formen des Text- und Data-Minings (automatisierte Analyseverfahren zur Mustererkennung, um generative KI zu trainieren).
Diese so genannten Schranken erlauben jedoch nicht automatisch jede KI-Nutzung. Auch die Verarbeitung personenbezogener Daten in den verwendeten Inhalten wirft eigene datenschutzrechtliche Fragen auf. Gleichzeitig versucht der Gesetzgeber, das Recht so auszugestalten, dass KI-Innovationen nicht unnötig behindert werden.
Freie Lizenzen sind kein Freibrief
Wikipedia und die anderen Wikimedia-Projekte nehmen innerhalb dieser Debatte eine besondere Position ein: Ihre Inhalte stehen in der Regel unter freien Lizenzen. Das ermöglicht eine weitreichende Weiternutzung – allerdings unter bestimmten Bedingungen. Dazu gehören je nach Lizenz insbesondere die Namensnennung und die Weitergabe unter denselben Lizenzbedingungen.
Wer solche Inhalte nutzt, kann also nicht einfach so tun, als seien sie komplett frei verfügbar. Freie Lizenzen bedeuten nicht, dass die Rechte der Urheber*innen keine Rolle mehr spielen. Sie schaffen vielmehr einen Rahmen, in dem Inhalte genutzt und weitergegeben werden können.
Eine interessante Besonderheit ist die freie Datenbank Wikidata: Die dort bereitgestellten strukturierten Daten stehen unter CC0 – der freien Lizenz-Form, die eine komplett uneingeschränkte Nutzung zulässt . Damit verzichtet die ehrenamtliche Wikidata-Community auf urheberrechtliche Schutzpositionen, weshalb die Daten besonders unkompliziert weiterverwendet werden können.
Doch was bedeutet das für Anbieter generativer KI-Systeme, die Wikipedia-Inhalte nutzen? Die rechtliche Lage ist differenziert zu betrachten. Die Nutzung von Texten und Bildern kann eine Lizenzpflicht auslösen. Werden die Bedingungen einer freien Lizenz nicht eingehalten, kann das einen Lizenzverstoß darstellen. Andersherum gibt es keinen rechtlichen Anspruch darauf, dass jede KI-Antwort die verwendete Quelle nennt.
Wie lässt sich Freies Wissen langfristig sichern?
Damit wird ein Widerspruch sichtbar: Wikimedia-Inhalte sollen als Freies Wissen von möglichst vielen Menschen genutzt werden können. Aber diese Offenheit ist kein Freibrief, die Bedingungen ihrer Nutzung zu ignorieren. Hinzu kommt eine ganz praktische Herausforderung auf technischer Ebene. Wenn KI-Unternehmen massenhaft Inhalte für das Training ihrer Algorithmen abrufen, belastet das die Server-Infrastruktur von einem spendenfinanzierten Projekt wie Wikipedia enorm. Gleichzeitig greifen Menschen seltener direkt auf Wikipedia zu, wenn sie ihre Antworten zunehmend bei einer KI befragen. Das beeinträchtigt auch die Beteiligung und die Spendenbereitschaft von Nutzenden, auf die das Projekt angewiesen ist.
Die Wikimedia Foundation spricht deshalb mit KI-Anbietern darüber, wie sich unnötiges automatisiertes Abrufen vermeiden lässt, wie eine angemessene Unterstützung aussehen kann und wie die Herkunft der genutzten Inhalte sichtbar gemacht werden kann.
Die juristische Perspektive zeigt: Die Communitys rund um Freies Wissen suchen derzeit nach Regeln, mit denen die Offenheit weiterhin gewahrt bleibt. Gleichzeitig haben der Gesetzgeber und die Gerichte noch keine abschließende Lösung für die darunter liegenden urheberrechtlichen Fragen gefunden – sowohl für herkömmliche als auch für freie Lizenzmodelle.
Die Perspektive der Community: Hinter dem Wissen stehen Menschen
Wer Wikipedia nutzt, sieht meist nur den fertigen Artikel. Dahinter steckt die Arbeit vieler Ehrenamtlicher, die recherchieren, Quellen prüfen, Fehler korrigieren und Wissen gemeinsam pflegen. Wikipedia lebt von Offenheit und gemeinsamen Regeln: Inhalte müssen neutral formuliert und durch verlässliche Quellen belegt sein. Die Motivation der Freiwilligen ist vielfältig – viele möchten Wissen teilen und Informationen bewahren, die sonst kaum dokumentiert würden.
Was passiert nun mit der Arbeit dieser Menschen, wenn KI-Systeme die Inhalte nutzen? Viele Wikipedia-Aktive stehen dieser Nutzung grundsätzlich offen gegenüber. Dass Wissen weitergenutzt wird und auch Menschen erreicht, die nicht direkt auf Wikipedia nachschlagen, widerspricht nicht unbedingt ihrer Motivation. Wissen soll schließlich frei zugänglich sein.
Problematisch wird es, wenn KI-generierte Texte mit falschen Aussagen oder erfundenen Quellen zusätzlichen Prüfaufwand verursachen. Deshalb ist es in der deutschsprachigen Wikipedia verboten, KI-Systeme zum Erstellen von Artikelinhalten einzusetzen.
Zum anderen belasten automatisierte Zugriffe durch KI-Anbieter die technische Infrastruktur der Wiki-Projekte massiv. Die Rufe nach Schutzmaßnahmen gegen massenhafte Abrufe durch KI-Bots stehen mitunter nützlichen KI-Werkzeugen, die Wikipedia-Autor*innen ihre Arbeit erleichtern können gegenüber. Und dann gibt es da noch eine längerfristige Sorge: Wenn Menschen Antworten zunehmend direkt von KI erhalten, kommen sie womöglich seltener mit Wikipedia in Kontakt – und beteiligen sich weniger. Damit stellt sich eine zentrale Frage: Wie bleiben die Menschen sichtbar, deren ehrenamtliche Arbeit die Wissensgrundlage für KI-Antworten überhaupt erst schafft?
Gute Antworten brauchen mehr als gute Algorithmen
Es zeigt sich: Die Zukunft der Wikipedia ist eng mit der Zukunft von KI verknüpft. Ohne eine verlässliche Wissensbasis verlieren auch KI-Systeme an Qualität. Wer das Wissen anderer nutzt, trägt also eine wichtige Verantwortung: KI-Anbieter müssen die Arbeit hinter ihren Antworten respektieren, die Herkunft der genutzten Inhalte nachvollziehbar machen und dazu beitragen, dass offene Wissensprojekte langfristig bestehen können.
Denn die Frage ist nicht nur, wem das Wissen hinter den KI-Antworten gehört – sondern auch, wer Verantwortung dafür übernimmt, dass es morgen noch da ist.