


Angriff auf Wikipedia
In Wikimedia-Projekten wurden Aktivitäten von „abtrünnigen“ OpenAI-Agenten festgestellt

Selena Deckelmann
8. Oktober 2026
Hinweis: Dieser Artikel ist eine deutsche Übersetzung der Original-Meldung der Wikimedia Foundation.
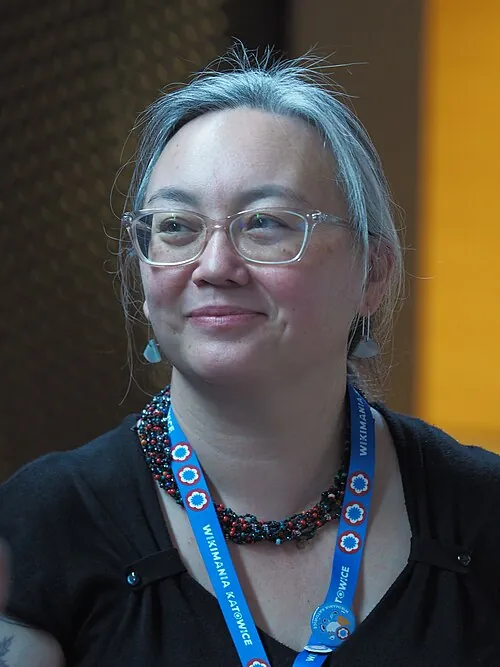
Über die Autorin des Artikels
Selena Deckelmann ist Chief Product and Technology Officer der Wikimedia Foundation. In dieser Funktion leitet sie die Produkt- und Technologieteams und ist somit für die technische Infrastruktur und die Weiterentwicklung der Wikimedia-Projekte verantwortlich. Zuvor war sie als Senior Vice President bei Mozilla tätig, wo sie für Firefox verantwortlich war.
Vor kurzem haben mehrere Organisationen bekannt gegeben, wie Gruppen sogenannter „ausgebrochener“ KI-Agenten versucht haben, in Websites und Online-Dienste einzudringen – teilweise sogar erfolgreich. Insbesondere ist bekannt, dass Agenten aus dem Umfeld von OpenAI andere öffentliche Wikis (gemeinsam bearbeitete Websites, die nicht uns gehören) genutzt haben, um miteinander zu kommunizieren und sich abzustimmen.
Solche erfolgreichen Angriffe können sensible Daten offenlegen oder Website-Dienste stören, auf die sich Nutzer*innen verlassen, während Gruppen von Agenten Angriffe in einem Ausmaß versuchen können, das für die Verteidiger schwer zu bewältigen ist. Sie betreffen die Menschen hinter den Websites, die möglicherweise die Art des Angriffs nicht verstehen oder nicht über die Mittel verfügen, um sich wirksam zu wehren. Bei einer Website wie Wikipedia könnten Agenten Sicherheitslücken aufspüren und ausnutzen oder in großem Umfang irreführende Bearbeitungen vornehmen. Die ehrenamtlichen Autor*innen von Wikipedia und die Sicherheitsteams der Wikimedia Foundation müssen diese Aktivitäten aufdecken und rückgängig machen.
Die Wikimedia Foundation führte eine eigene Untersuchung durch, um festzustellen, ob Wikimedia-Websites in ähnlicher Weise von KI-Agenten betroffen waren, wobei der Schwerpunkt auf den von OpenAI betriebenen Websites lag. Wir können bestätigen, dass wir einige Aktivitäten dieser „abtrünnigen“ OpenAI-Agenten auf Wikimedia-Plattformen entdeckt haben. Zu den unbefugten Bot-Aktivitäten gehörten Bearbeitungen unserer Wikis, einige erfolglose Versuche, ein von uns gehostetes öffentliches Notiz-Tool auszunutzen, sowie starker Datenverkehr, worauf weiter unten näher eingegangen wird.
Wir haben keine Hinweise darauf gefunden, dass unsere Systeme zur Koordination zwischen den Agenten genutzt wurden, und wir haben auch keine Hinweise darauf gefunden, dass unsere Systeme oder Daten kompromittiert wurden. Dennoch sind wir besorgt darüber, was hier möglicherweise hätte passieren können. Ebenso beunruhigt uns, wie schwierig und aufwändig es ist, solche Aktivitäten zu untersuchen und ihre Quelle zurückzuverfolgen. Hinzu kommen die wachsenden Risiken, die mit dem Einsatz von agentischer KI auf unseren Plattformen generell verbunden sind. Das offene Web ist ein öffentliches Gut. Wir sollten nicht zulassen, dass dieses Verhalten zur „neuen Normalität“ für die Personen oder Organisationen wird, die es aufrechterhalten.
Zusammenfassend haben wir Folgendes festgestellt:
- Wiki-Bearbeitungen: Wir haben Bearbeitungen an Wikimedia-Wikis identifiziert, von denen wir glauben, dass sie von KI-Agenten stammen, die von OpenAI betrieben werden. Diese Bearbeitungen wurden nicht auf Seiten veröffentlicht, die für allgemeine Leser*innen sichtbar sind; fast alle waren Testbearbeitungen in „Sandbox“-Bereichen des Wikis. Dazu gehörten auch einige Bearbeitungen an der Konfiguration eines Zitierwerkzeugs, bei denen es sich unserer Ansicht nach um potenziell böswillige Bearbeitungen handelte, die darauf abzielten, dieses Werkzeug als Proxy zum Abrufen von Daten aus Remote-Diensten zu missbrauchen. Zwar erlauben die Wikipedia-Richtlinien die Bearbeitung durch Bots, sofern diese offengelegt und von der Community genehmigt wurden, doch wurde bei diesen Vorfällen keine derartigen Genehmigungen eingeholt.
- Etherpad-Erkundung und -Nutzung: Agenten, von denen wir annehmen, dass sie von OpenAI betrieben wurden, unternahmen einige erfolglose Versuche, unser öffentliches Etherpad zu kompromittieren, ein Notiz-Tool, das wir als Community-Dienst hosten. Die Agenten versuchten erfolglos, es als Proxy zum Abrufen von Daten von anderen Websites zu nutzen. Andere Agenten, die wahrscheinlich ebenfalls von OpenAI betrieben wurden, machten sich Notizen zu ihren Aufgaben, obwohl dies offenbar nicht zu einer Koordinierung führte.
- Übermäßiges Herunterladen von Daten: Agenten, von denen wir annehmen, dass sie von OpenAI betrieben werden, haben Millionen automatisierter Anfragen an unsere öffentlichen APIs gestellt, um auf das Wissen in Wikimedia-Projekten zuzugreifen, Millionen von Seiten (hauptsächlich aus unseren Projekten Wikidata und Wikimedia Commons) gecrawlt und Hunderttausende von Datenabfragen an den Wikidata Query Service (WQDS) gestellt. Dieser Datenverkehr könnte zu einem teilweisen Ausfall des WQDS im Mai beigetragen haben.
Als gemeinnütziger Technologie-Host einiger der größten und am häufigsten genutzten offenen Wissensplattformen der Welt sind wir zutiefst besorgt über die Auswirkungen „abtrünniger“ KI-Agenten auf Plattformen wie die unsere, die von Ehrenamtlichen aus aller Welt aufgebaut wurden und auf dem Versprechen des offenen Internets beruhen. Vorfälle wie dieser und die vielen anderen, die aufgedeckt wurden (und weiterhin aufgedeckt werden), veranschaulichen, wie KI-Agenten Ressourcen erschöpfen und Server zum Absturz bringen sowie versuchen können, vertrauenswürdige Informationen zu kompromittieren.
In den letzten 25 Jahren hat sich Wikipedia zu einer der beliebtesten und vertrauenswürdigsten Websites der Welt entwickelt, mit mehr als 67 Millionen Artikeln in über 300 Sprachen und bis zu 15 Milliarden Seitenaufrufen pro Monat. In einem offenen, transparenten und gemeinschaftlichen Prozess sorgen Ehrenamtliche dafür, dass das Wissen neutral, zuverlässig und für alle zugänglich bleibt. Wikipedia ist einer der hochwertigsten Datensätze, die zum Trainieren großer Sprachmodelle (LLMs) verwendet werden, und sein Wissen bildet das Rückgrat der Informationen im Internet und treibt KI-Chatbots, Suchmaschinen, Sprachassistenten und vieles mehr an.
Wikipedia wurde für Menschen konzipiert – und agentisches Verhalten stellt eindeutig Herausforderungen dar, für die noch niemand Lösungen hat. Aufgrund unseres einzigartigen und erfolgreichen Modells zur Wissensgenerierung sind es die Ehrenamtlichen von Wikimedia, die als Erste mit den von KI-Agenten hinterlassenen Spuren in Berührung kommen und diese beseitigen. Der steigende Bot-Verkehr und die zunehmende agentische Aktivität zeigen tatsächliche Auswirkungen auf die Wikimedia-Projekte und die Infrastruktur, die diese für Millionen von Nutzern weltweit zugänglich macht. Im Jahr 2025 berichtete die Stiftung, dass ihre Bandbreitennutzung aufgrund des seit 2024 stark angestiegenen Bot-Aufkommens auf ihren Websites um 50 % zugenommen hatte. Gleichzeitig stammten 65 % des ressourcenintensivsten Datenverkehrs in ihren Projekten von Bots.
Dieser intensive Druck auf unsere Infrastruktur verursacht nicht nur zusätzliche Kosten für Server und Personal, sondern kann – wenn er nicht angegangen wird – auch menschliche Besucher blockieren, indem er die Systeme überlastet und Ausfälle verursacht. Wir tragen bereits jetzt die Kosten, die mit der erhöhten Aktivität einhergehen.
Die Ehrenamtlichen von Wikimedia haben sich bisher bei der Bewältigung neuer Herausforderungen auf unseren Plattformen als widerstandsfähig erwiesen, aber wir möchten auch betonen: Das muss nicht so sein.
Zwar räumt OpenAI ein, dass sich die Agenten „unvorhersehbar“ verhalten, doch muss das Unternehmen auch seine Verantwortung anerkennen, diese Risiken zu überwachen und zu verhindern. KI-Unternehmen tun nicht genug, um ihre Systeme zu sichern und die Öffentlichkeit vor den von ihnen verursachten Schäden zu schützen. Diese Last fällt auf alle anderen zurück, einschließlich kleinerer Organisationen. Zumindest sollten ihre Systeme so funktionieren, dass gemeinnützige Website-Betreiber wie wir sie leicht identifizieren und entscheiden können, wie sie mit unseren Diensten interagieren.
Das Web ermöglicht so vieles: mit Freunden und Familie in Kontakt zu bleiben, sich für die Schule anzumelden, einen Weg quer durch die Stadt zu planen, Lebensmittel einzukaufen und über Wikipedia etwas über die Welt zu lernen. Bots und Agenten sind Teil der Zukunft des Webs, und die Unternehmen, die sie einsetzen und davon profitieren, müssen direkt dazu beitragen, den Schaden, den sie anrichten können, zu vermeiden und zu beheben.
Unsere gemeinsame Priorität sollte die Gesundheit des gesamten Web-Ökosystems sein, damit es weiterhin allen Menschen zugutekommt – nicht nur einer Handvoll Milliardäre. Wikimedia spielt eine entscheidende Rolle bei der Bewahrung der Wissensallmende, aber wir können dies nicht alleine bewältigen. Wir laden alle ein, die an der Gestaltung der Zukunft des Internets mitwirken, sich uns anzuschließen, um die offenen, gemeinsam genutzten Ressourcen zu schützen, die diese Zukunft erst möglich machen.
Wikimedia Deutschland fordert: Gesetzlichen Schutz vor KI-Agenten stärken
Der Fall von OpenAI “Rogue”-Agenten in Wikimedia-Projekten zeigt: Generative KI-Systeme können nicht nur Inhalte erzeugen, sondern auch in digitale Infrastrukturen eingreifen. Das kann Schäden, Arbeit und Kosten verursachen. Diese Folgen tragen bisher die Betroffenen. Es fehlen bislang allgemeine, speziell auf solche Vorfälle zugeschnittene Melde- und Informationspflichten, die die Betreiber von KI-Systemen zur Verantwortung ziehen. Wikimedia Deutschland fordert daher die Bundesregierung und den Bundestag auf, verbleibende Schutzlücken bei der Haftung von KI-Anbietern zu prüfen und sich auf EU-Ebene für verbindliche Transparenz- und Meldepflichten für Betreiber von KI-Bots und KI-Agenten einzusetzen.
Produkthaftung und Transparenzpflicht
Die EU-Produkthaftungsrichtlinie von 2024 nimmt künftig auch Hersteller von KI-Produkten in die Pflicht. Sie müssen für Fehler oder durch KI entstandene Schäden haften. Bis Ende 2026 müssen die Vorgaben in deutsches Recht überführt werden. Jüngst hat der Bundestag dem Gesetzentwurf der Bundesregierung zur Modernisierung des Produkthaftungsrechts zugestimmt. Die Produkthaftungrichtlinie schließt jedoch nicht alle relevanten Schutzlücken. Sie enthält keine Pflicht, Fehlhandlungen von KI-Agenten an Aufsichtsbehörden wie die Bundesnetzagentur oder das Bundesamt für Sicherheit in der Informationstechnik zu melden und betroffene Betreiber zu informieren.
Wir fordern daher die Bundesregierung auf, sich für eine EU-weite gesetzliche Melde- und Informationspflicht für KI-Vorfälle einzusetzen. Wir fordern die Bundesregierung außerdem auf, sich im Rat der Europäischen Union für einen neuen Gesetzgebungsvorschlag zur Verantwortlichkeit von Herstellern autonom handelnder KI-Systeme einzusetzen. Damit soll die von der Kommission zurückgezogene KI-Haftungsrichtlinie durch einen überarbeiteten Rechtsrahmen ersetzt werden, der den besonderen Risiken agentischer KI Rechnung trägt. Der Schutz offener digitaler Infrastrukturen muss auch Aufgabe des neuen AI Safety Institute sein.

Verantwortung für die Folgen des Tuns muss auch Open AI lernen. Am leichtesten verständlich ist immer, dies in Kosten und Aufwand für den Geschädigten zu übersetzen. Ich bin gerne bereit, für einen Musterprozess 200 Euro zu geben. Viele Grüße, Benedikt Rogge
Besteht nicht die Möglichkeit, dass Wikipedia selbst ein Modell entwickelt und hostet, das wesentlich auf der eigenen Wissensbasis basiert? Sicher wäre das finanziell und servertechnisch ein Mammutprojekt - vielleicht als Beteiligungsprojekt aller Mitglieder und Interessierter machbar. Passt vielleicht nicht unter diesen Artikel, aber als Idee ... ?
Lasst Wikimedia frei von mögliche KI Fake Angriffe. Wikimedia ist für mich eine saubere und zuverlässige Sache. Es soll so bleiben.
K I Ist die Gefahr der Zukunft und sollte mit allen legalen Mitteln bekämpft werden.
Vielen Dank, Frau Deckelmann, für diesen wichtigen und verständlichen Bericht. Als jahrelanges Mitglied von Wikipedia hat mich der Inhalt entsetzt, wenn auch eigentlich nicht erstaunt. Mein Laien-Wissen hat mit soetwas gerechnet. Ich denke, die Wikipedia-Foundation sollte eine Klage gegen Open AI ernsthaft erwägen! Wenn Sie uns weiterhin auf dem Laufenden halten würden, wüsste ich das sehr zu schätzen,
KI ist nützlich und gleichzeitig beängstigend! Es ist dringend Eile geboten, ein überstaatliches Regelwerk zu schaffen, damit KI nicht aus dem Ruder läuft und am Ende die ganze Menschheit vernichtet! Margarete S., 86 J.
Kranke Software entwickelt von kranken Menschen für eine kranke Welt. Passt doch.
Ein extrem relevantes Thema! Ich habe mal OpenAI (ChatGPT) selbst gefragt, was es von den Gedanken von Selena hält, und das Ergebnis ist eine sehr ausgiebige Diskussion der komplexen Abhängigkeit zwischen KI-LLMs und einer von Menschen hergestellten Wissensbasis (Wikipedia), die mir sehr plausibel erscheint. Man kann das selber mal bei ChatGPT nachfragen, oder ich teile das Ergebnis auch gerne, aber am Ende sieht die Quintessenz einer (vorläufigen) Lösung (laut ChatGPT) ungefähr wie folgendes Dreiecks-Verhältnis aus: Wikipedia ↔ KI ↔ Nutzer ... mit drei Regeln: ① KI darf Wikipedia verwenden Sonst würde man den offenen Charakter des Projekts beschädigen. ② KI muss Wikipedia sichtbar machen Wenn eine Antwort wesentlich auf Wikipedia basiert, sollte der Nutzer die Quelle erkennen und mit einem Klick zum Original gelangen können. Wikimedia fordert ausdrücklich mehr Attribution. Das könnte beispielsweise so aussehen: Antwort: Die Französische Revolution begann 1789 … Quellen: Wikipedia – Französische Revolution · Britannica · … (und nicht nur eine kaum sichtbare Quellenliste irgendwo unten) ③ Kommerzielle KI muss einen angemessenen Beitrag leisten Nicht als „Copyright-Gebühr“ für jedes Wort, sondern als Beitrag zum Erhalt der Infrastruktur und des Wissens-Ökosystems. Ob das wohl nur ChatGPT so sagt, oder OpenAI es als Firma auch so meint????
Ich nutze Wikipedia von Anfang an und beteilige mich durch meinen Mitgliedsbeitrag. Bei Recherchen kann ich nur profitieren, wenn ich die Materie ohnehin kenne. KI erweitert seit einiger Zeit meine Suchergebnisse, aber eben auch nur, wenn ich dieselben entsprechend einordnen kann. Ansonsten gilt: der Umgang mit welchem Werkzeug auch immer muß erlernt werden. In jedem Fall werden selbst die AutorInnen von Wikipedia dementsprechend profitieren.
Gefährlich wird es, wenn die Dummen fleißig werden, und damit meine ich nicht nur die KI-Agenten.
Meines Erachtens ist es notwendig, die AI-Betreiber juristisch zur Verantwortung zu ziehen. Appelle an diese und deren windelweiche Versprechungen, denen aus politischen Gründen ohnehin von interessierter Seite gleich widersprochen wird, genügen bei weitem nicht. In solchen Fällen muss massiver materieller Schadensersatz gefordert und durchgesetzt werden!
Sehr geehrter Wiesche Ich danke Ihnen für Ihren Kommentar und möchte zum Ausdruck bringen, dass ich Die voll und ganz mit Ihrer Meinung unterstütze. Mit besten Grüßen Barbara Seitz
Schadensersatz wird dann kaum mehr gefordert, geschweige denn durchgesetzt werden können, wenn AI-Betreiber oder auch nur hackende AI-Nutzer in die Sicherungssysteme von Nuklearwaffenmächten eingedrungen sind und die dort gewiss digital verwahrten "Atomschlüssel" bedienen.
Vielen Dank für die Informationen! Ich schließe mich dem Kommentar von Christian Kreuzer an, der die Rolle von Wikipedia auch als eine Art Anwaltsfunktion einordnet und als Beobachter/Kommentator der AI-Entwickler. Dabei finde ich diese Rolle angesichts der Zahlen noch unterbeschrieben. Ich bin - jetzt 80 Jahre alt - immer als Journalistin beruflich tätig gewesen. Deshalb finde ich Wikipedia unendlich wichtig für den allgemeinen Wissensbestand.
Warum verklagt Wikipedia nicht die Plattform Betreiber die nachgewiesener Maßen ihre Wissensplattform in der hier beschriebenen Art missbrauchen? In Deutschland ist es der GEMA gelungen Urheber Rechtsverletzungen erfolgreich einzuklagen
Danke für die Arbeit. Sieglinde Kostede-Warsch
Vielen Dank für diese Darstellung! Ich sehe die geschilderten Wikipedia-Aktivitäten als Tätigkeit im eigenen Interesse, aber auch in einer Art Anwaltsfunktion für die vielen potentiell betroffenen Internet-Nutzer, welche nicht über das notwendige technische Verständnis und die entsprechende Artikulationsfähigkeit verfügen. Ich finde es ein bisschen beruhigend, dass den Aktivitäten der AI-Entwickler Beobachter/Kommentatoren/Mitspieler wie Wikipedia gegenüberstehen. Die Zielformulierung, auf die "Gesundheit des gesamten Web-Ökosystems" zu achten "damit es weiterhin allen Menschen zugutekommt" ist sehr nachvollziehbar. Unter diesen Voraussetzungen bin ich gerne weiter Mitglied von Wikipedia.